
AI Agent 应用落地,CPU 的角色迎来重大转机。解析 CPU 需求的爆发成长,以及Intel与Nvidia、Arm等之间的竞争格局。
CPU 在 Agentic AI 应用的重要性
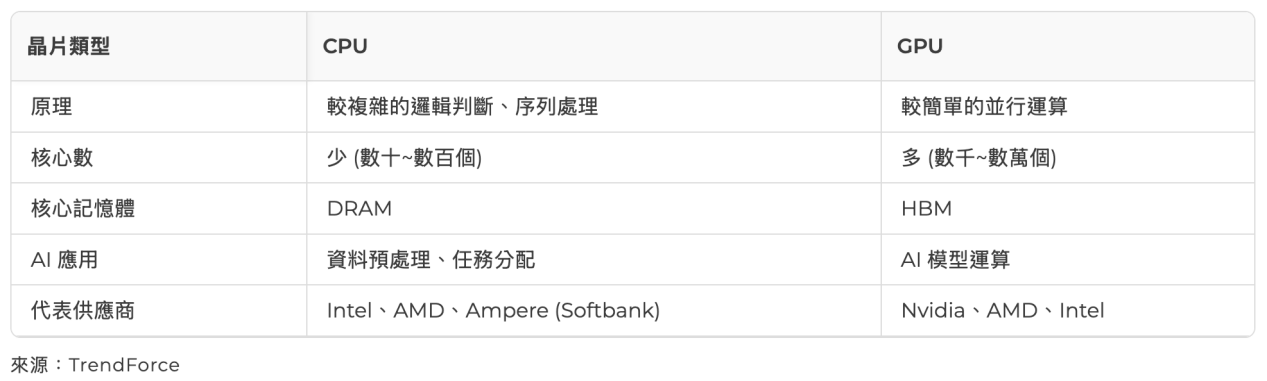
过往,在数据中心内,CPU 扮演服务器的“大脑”,负责所有复杂的逻辑判断、序列处理,在经典的机器学习 (Linear Regression、Decision Trees 等) 也表现出色。
然而,进入 AI 爆发时代,由于 AI 模型需要同时执行大量的矩阵运算 (Matrix Multiplication),并由具有高度并行性 (Embarrassing Parallelism) 的 GPU 同时进行大量简单数学运算,CPU 仅负责压缩、分配存储器中的数据给 GPU 工作,使得 GPU 的重要性逐渐超越 CPU。现今AI数据中心中,CPU:GPU 比例约为1:4至1:8。
表 1. CPU vs. GPU 比较
 然而,随着 AI Agent 的应用落地,CPU 的角色迎来重大转机。Agentic AI 与静态的 LLM 不同,旨在通过 Agents 和动态环境互动,使 AI 模型能够主动规划、呼叫工具,达到独立做出决策、代替用户执行行动。其中,协调 (Orchestration) 就是 CPU 的重要工作。在第一次呼叫 AI agent 后,AI Agent 会产生执行计划与许多 Sub-agents,而 CPU 必须负责协调 Sub-agents 间的任务编排、工具呼叫、数据传递,并整合 Sub-agents 的成果、评估原始请求是否已满足。因此,在 Agentic Inference 过程中会需要更多的 CPU。
图 1. CPU 在 Agentic Inference 过程中的角色
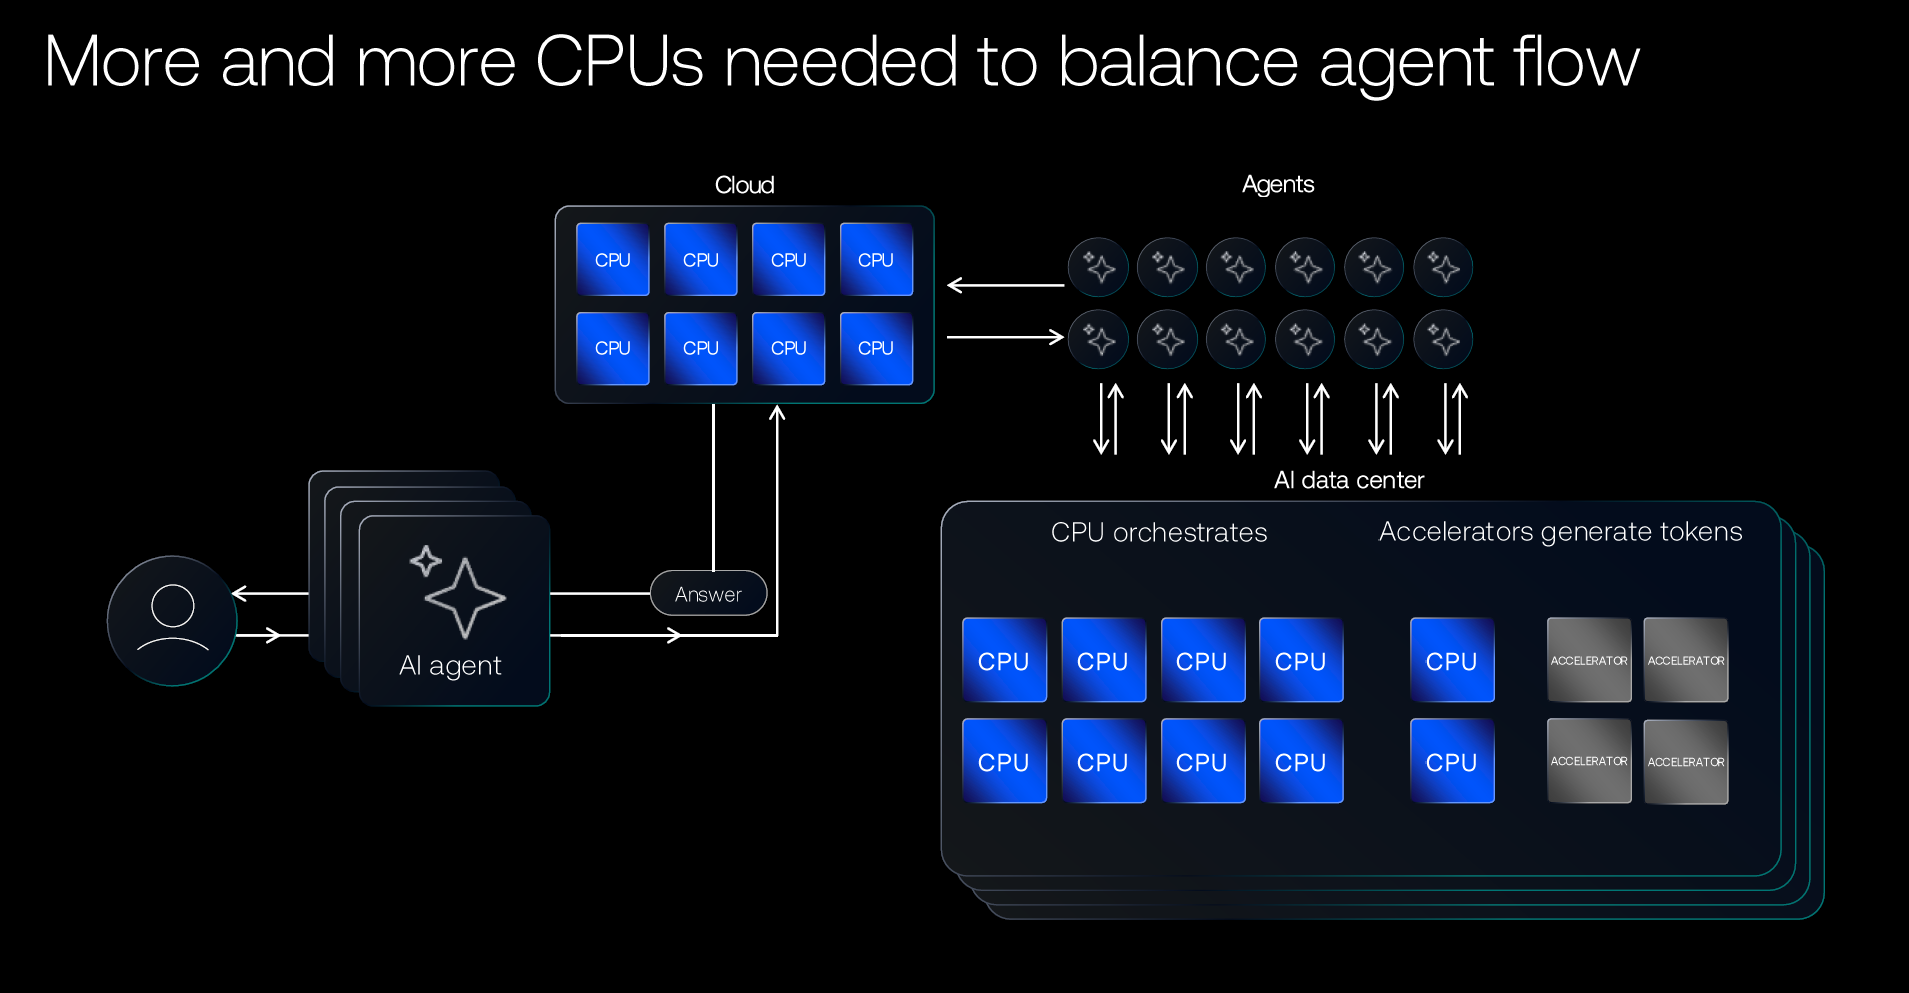 来源:Arm
此外,Agent AI 与强化学习 (Reinforcement Learning, RL) 结合形成的 Agentic RL 使得 CPU 更为重要。而对 AI Agent 的每一个行动进行评估 (Evaluation) 的过程进一步提升了 CPU 的需求。
2025 年 11 月,论文〈A CPU-Centric Perspective on Agentic AI〉也提出 CPU 在 Python 解译、网络爬虫、词汇式摘要、数据库搜寻等工具处理中仍扮演关键角色,而 Agentic AI 仍具备这些大量使用 CPU 的场景。因此,AI Agent 在 CPU 方面可能面临三大瓶颈:
- 延迟 (Latency):CPU 处理时间可能占总延迟的 90.6%。
- 吞吐量 (Throughput):吞吐量瓶颈可能是 CPU 因素 (核心数、一致性、同步性) 或 GPU 因素 (核心存储器容量、频宽)。
- 能耗 (Energy):在大批量处理时,CPU 动态功耗可能占总功耗的 44%。
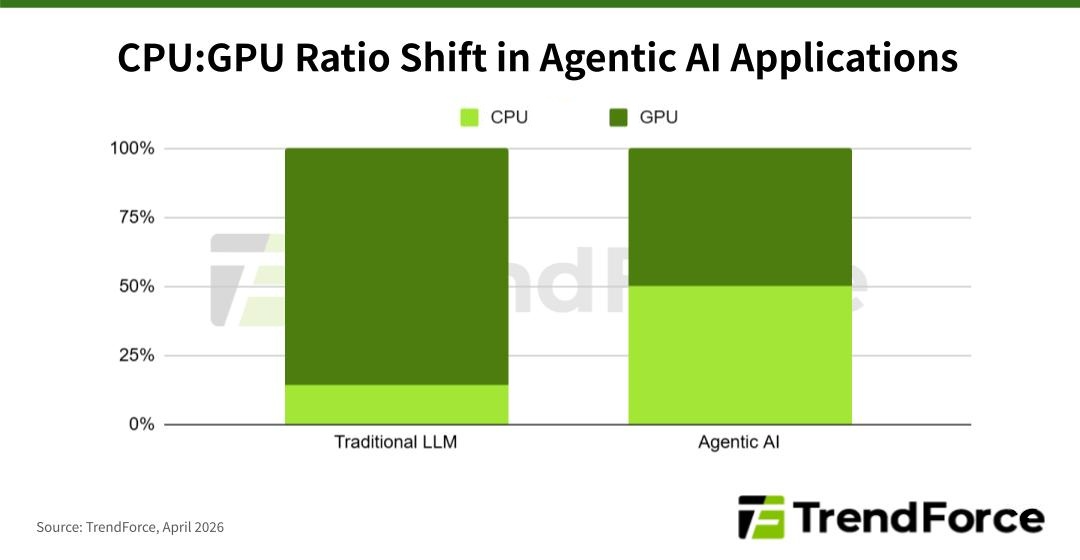
因此,过往的 CPU:GPU 比例需要改变。根据 Arm 推估,传统 AI 数据中心每 GW 约需要 3,000 万颗 CPU 核心。进入 AI Agent 时代后,需求将提升至 1.2 亿颗 CPU 核心、约 4 倍需求量。未来的 CPU:GPU 比例可能增至 1:1 至 1:2,使市场对 CPU 需求大幅升高。
图 2. Agentic AI 应用的 CPU:GPU 比例变化
来源:TrendForce
有关推理经济如何重塑 AI 芯片架构的深入分析,请参阅 推理经济崛起:AI 芯片规则正在改写。
由于 AI 数据中心对 AI 与一般服务器的 CPU 需求激增,也使得 Intel、AMD 在 1Q26 季底开始对部分 CPU 产品线涨价。
2026 年 CPU 市场竞争态势
在日益扩大的 CPU 市场中,除了传统服务器 CPU 供应商 Intel、AMD,许多非传统服务器 CPU 供应商也纷纷推出自研的 CPU 以切入新的业务、共同解决 AI 运算瓶颈,如 GPU 供应商 Nvidia、IP 供应商 Arm,以及 AWS、Google、Microsoft 等各大 CSP。
(一) 传统 x86 架构 CPU 供应商 (Intel、AMD)
Intel 的 Xeon 系列服务器 CPU 长年维持超过 95% 的市场份额,直到 2021 年因 Intel 7 工艺良率问题,导致 Xeon Sapphire Rapids 延后近两年量产,AMD 得以借 EPYC Milan(采用台积电 N7 工艺、Zen3 架构)实现市占突破。
2026 年,Intel 分别在高性能的 E-Core 和高性能的 P-Core 产品线推出 Xeon 6+ (Clearwater Forest) 与 Xeon 7 (Diamond Rapids)。
Xeon 6+ (Clearwater Forest) 采用全新的 Darkmont 架构,核心数/线程数高达 288/288,TDP 约 450W,并首次应用 Foveros Direct 的 Hybrid Bonding 技术。Xeon 7 (Diamond Rapids) 则采用全新的 Panther Cove-X 架构,核心数/线程达 256/256,TDP 约 650W。
AMD 则维持由台积电代工,2026 年推出的 EPYC Venice 为全新的 Zen6 架构,采用台积电 N2 工艺与 CoWoS-L、SoIC 先进封装,核心数/线程数可以高达 256/512。预计在采用台积电代工的策略下,AMD 2026 年将持续抢占 Intel 市占率。
(二) 新兴 Arm 架构 CPU 供应商 (Nvidia、Arm、Ampere、AWS、Google、Microsoft)
2026 年 3 月,Nvidia 在 GTC 大会宣布将单独销售 Vera CPU,以应对客户对 CPU:GPU 更灵活配置的需求,第一批合作厂商包括阿里巴巴、字节跳动、Cloudflare、CoreWeave、Crusoe、Lambda、Nebius、Nscale、Oracle、Together.AI、Vultr 等 CSP。
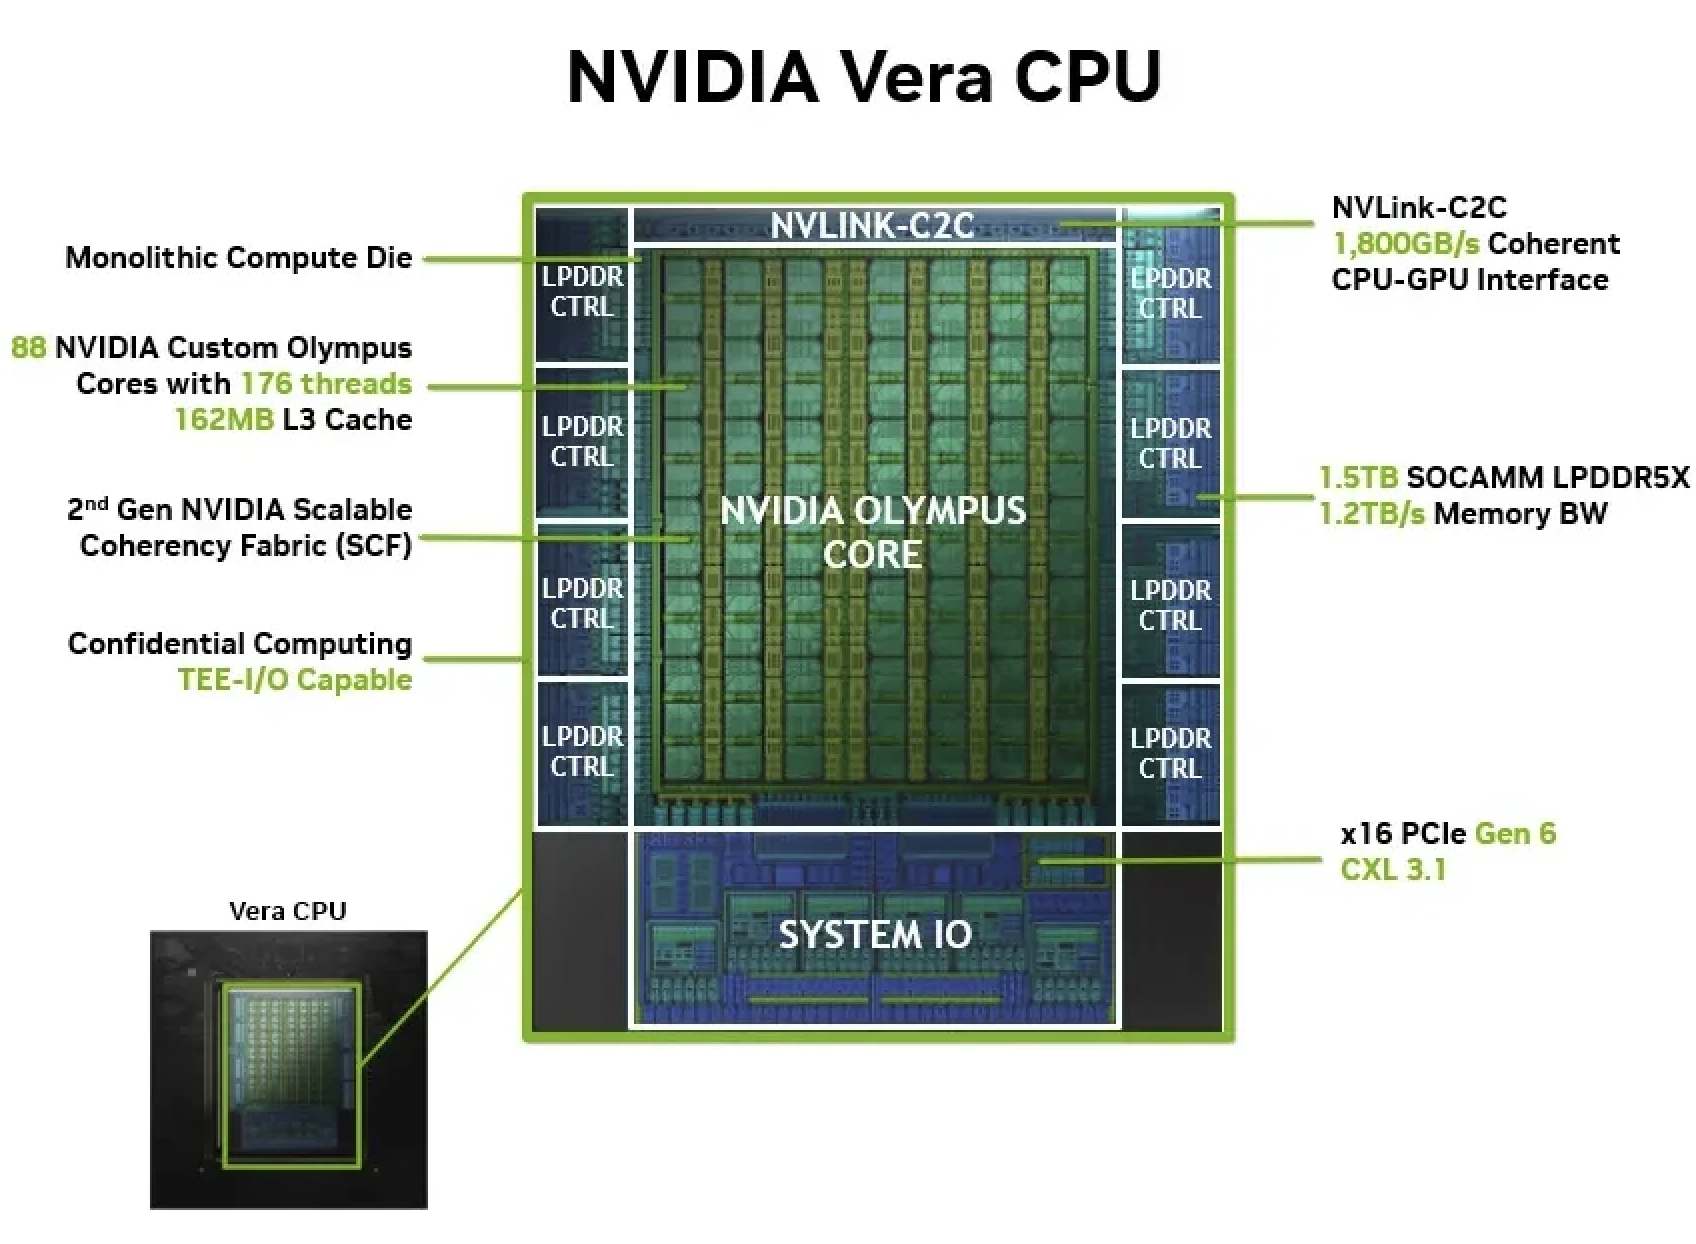
Vera CPU 首度采用 Nvidia 自研的 Olympus 架构,台积电 N3 工艺与 CoWoS-R 先进封装,并首度导入空间多线程 (Spatial Multithreading) 技术,核心数/线程数为 88/176。尽管核心数/线程数较 Intel、AMD 今年推出的旗舰 CPU 少,但身处 Nvidia 生态系的 Vera CPU 可与 Nvidia GPU 进行高达 1.8 TB/s 的 NVLink-C2C 互连,实现和 GPU 的内存共享。
图 3. Nvidia Vera CPU
 来源:Nvidia
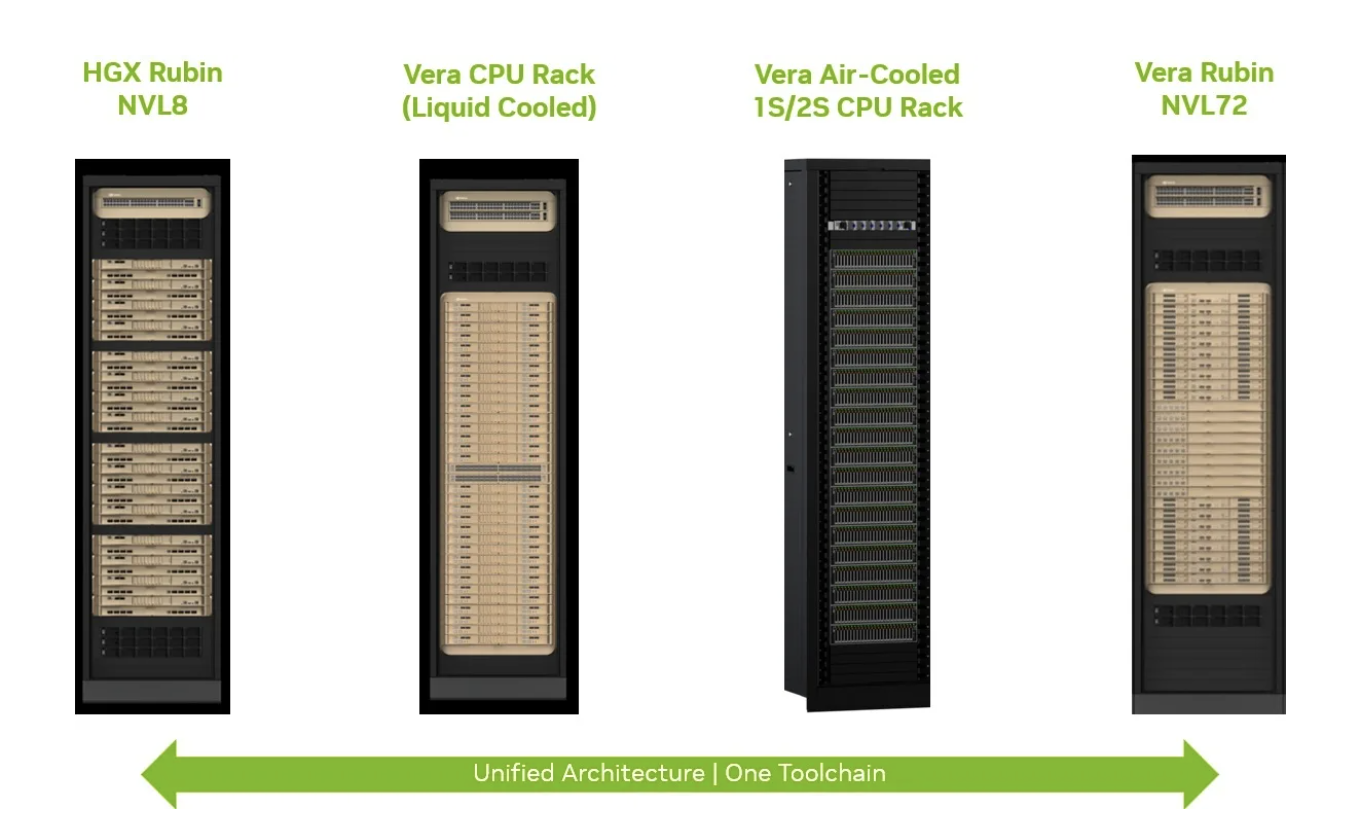
此外,Nvidia 推出基于 Nvidia MGX 架构的 Vera CPU Rack,单一个 rack 共有 32 个 1U compute tray,一个 compute tray 共有 4 个 Vera CPU Node,共可以整合 256 个 Vera CPU,整体核心数/线程数达 22,528/45,056,内存容量达 400 TB,并采用整合 Grace CPU、ConnectX-9 的 BlueField-4 DPU 与其他 Rack 互连,与 Nvidia 生态系高度整合。有关数据中心 scale-out 互联竞争的深入分析,请参阅 InfiniBand vs Ethernet:Broadcom 与 NVIDIA 的 Scale-Out 技术之战。
图 4. Nvidia Vera CPU Rack
 来源:Nvidia
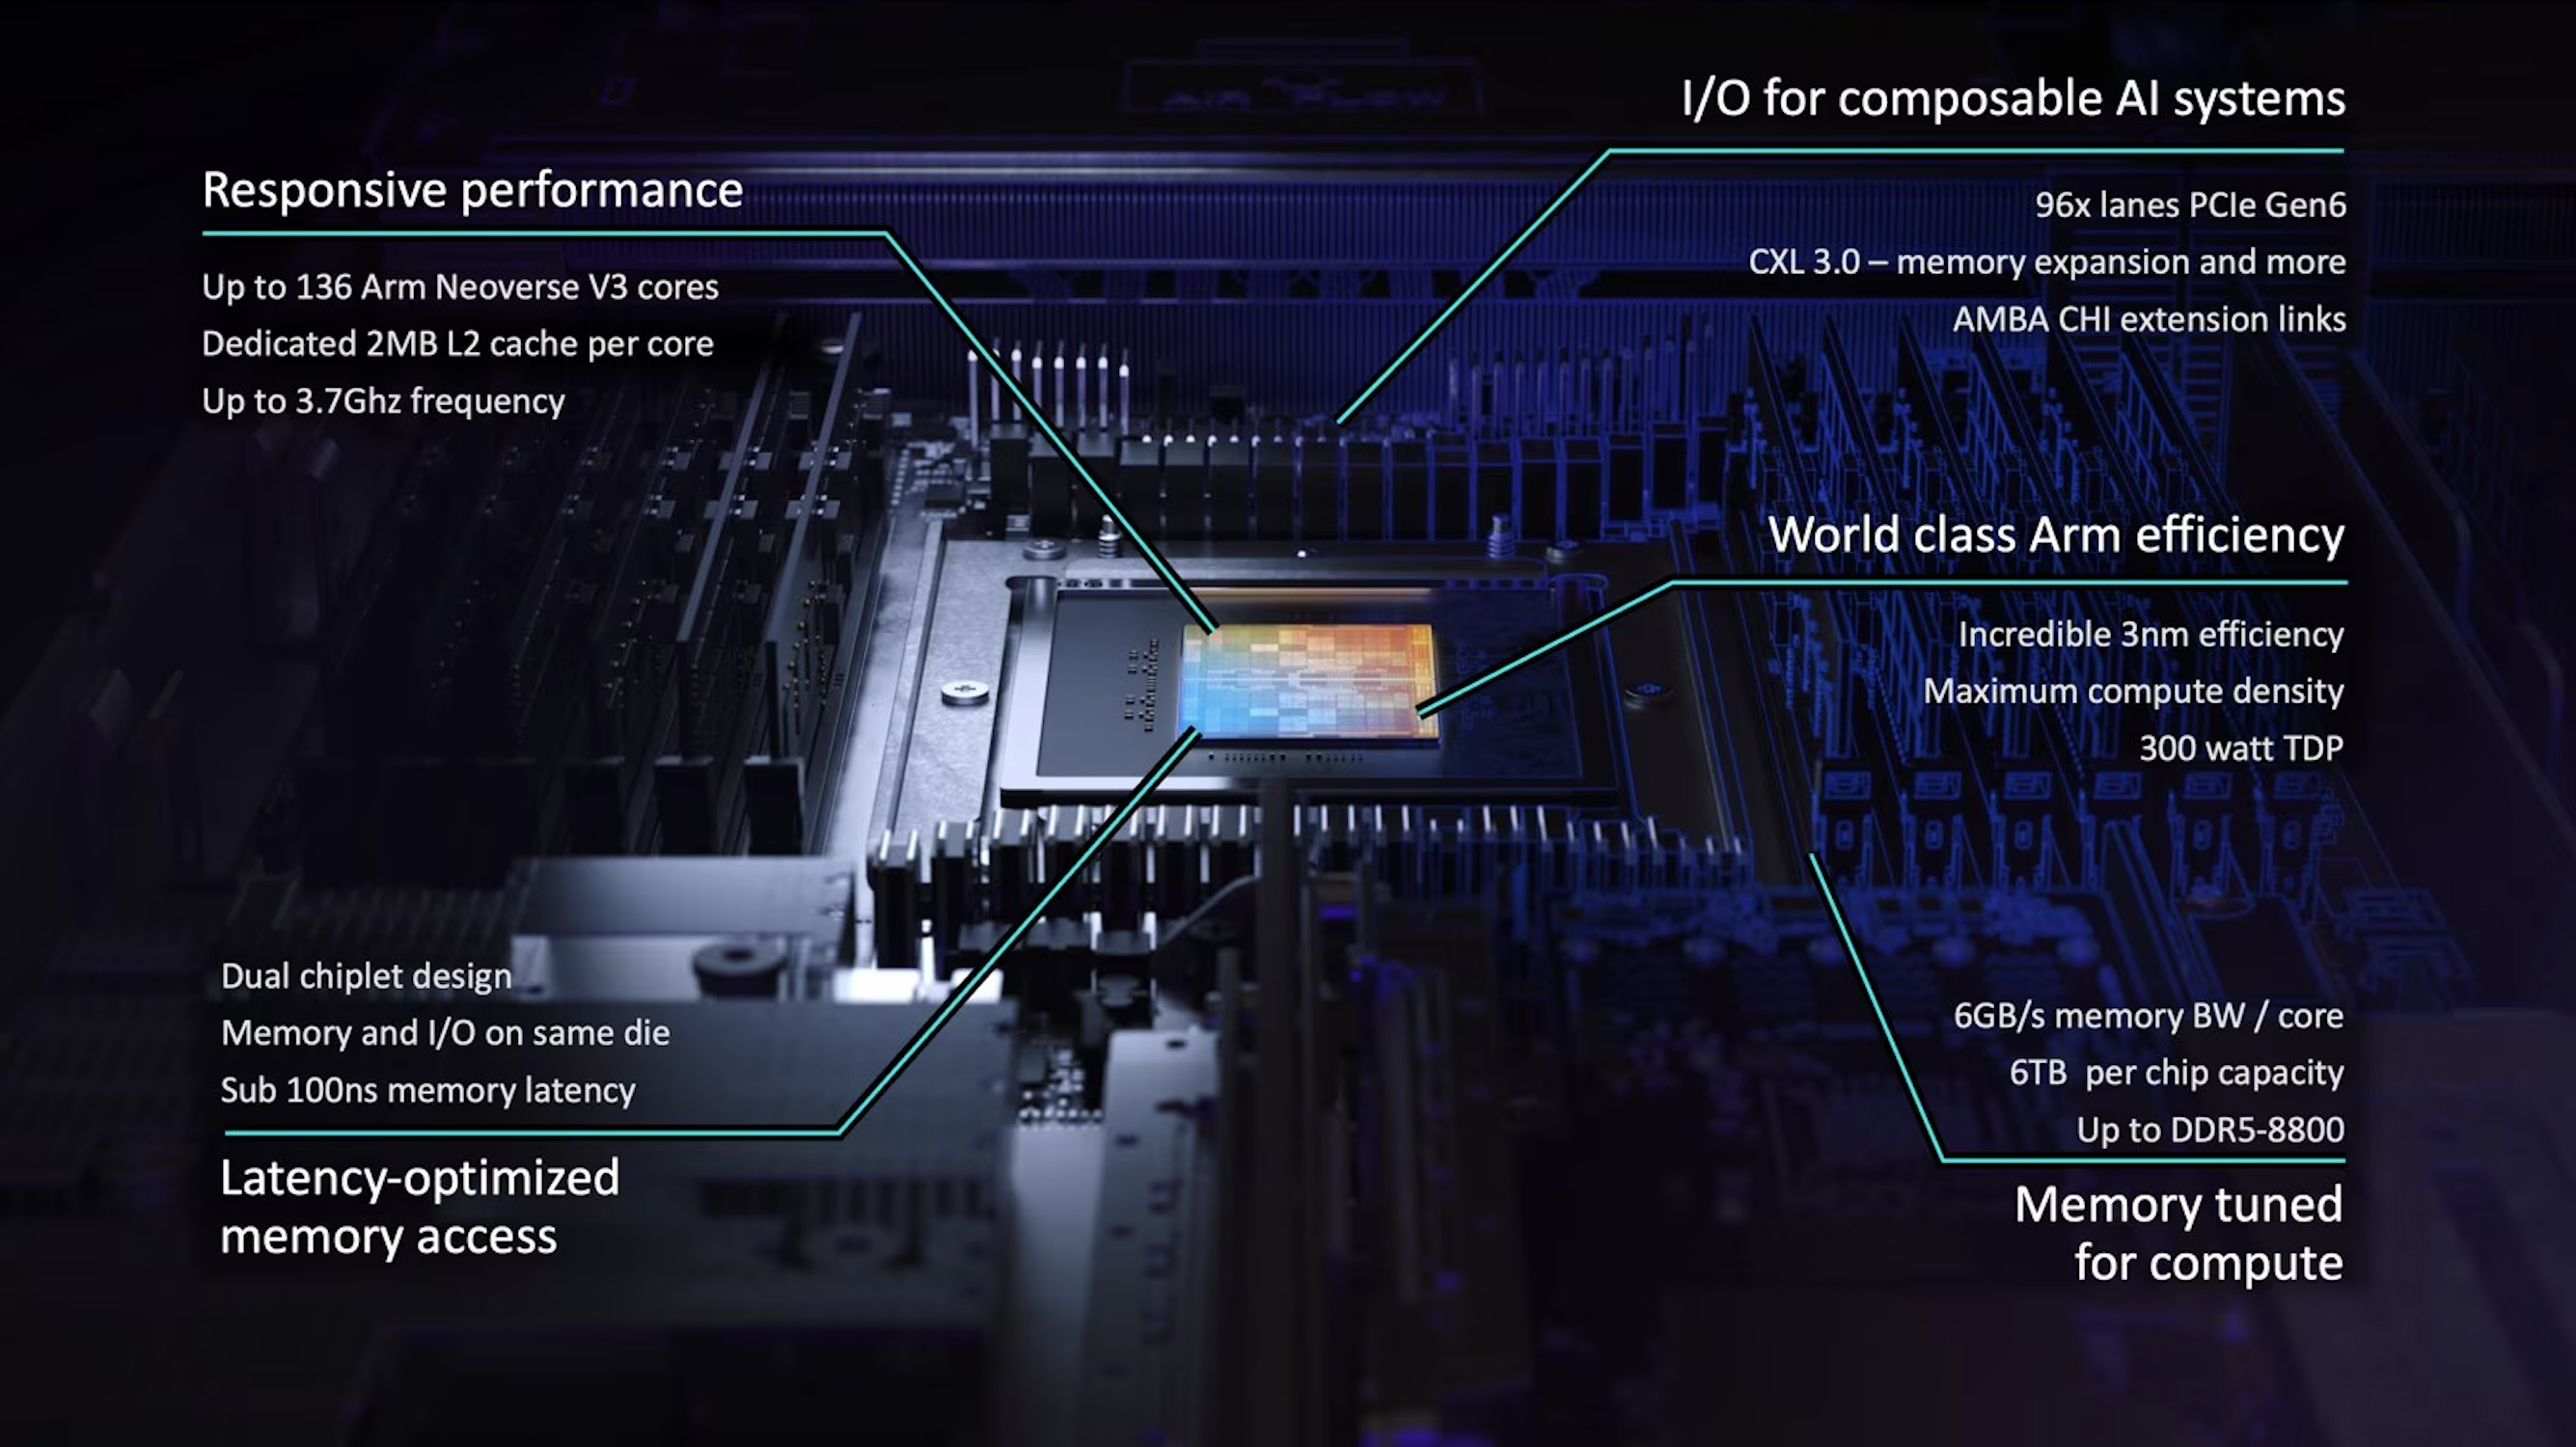
2026 年 3 月 25 日,Arm 架构 IP 大厂 Arm 也不约而同地改变商业模式,推出自研的 CPU 平台 Arm AGI CPU。第一款 Arm AGI CPU 采用台积电 N3 工艺,基于 Arm Neoverse V3 架构,核心数/线程数为 136/136。Arm AGI CPU 的首批合作伙伴包括 Meta、Cerebras、Cloudflare、F5、OpenAI、Positron、Rebellions、SAP、SK Telecom 等。
图 5. Arm AGI CPU
 来源:Arm
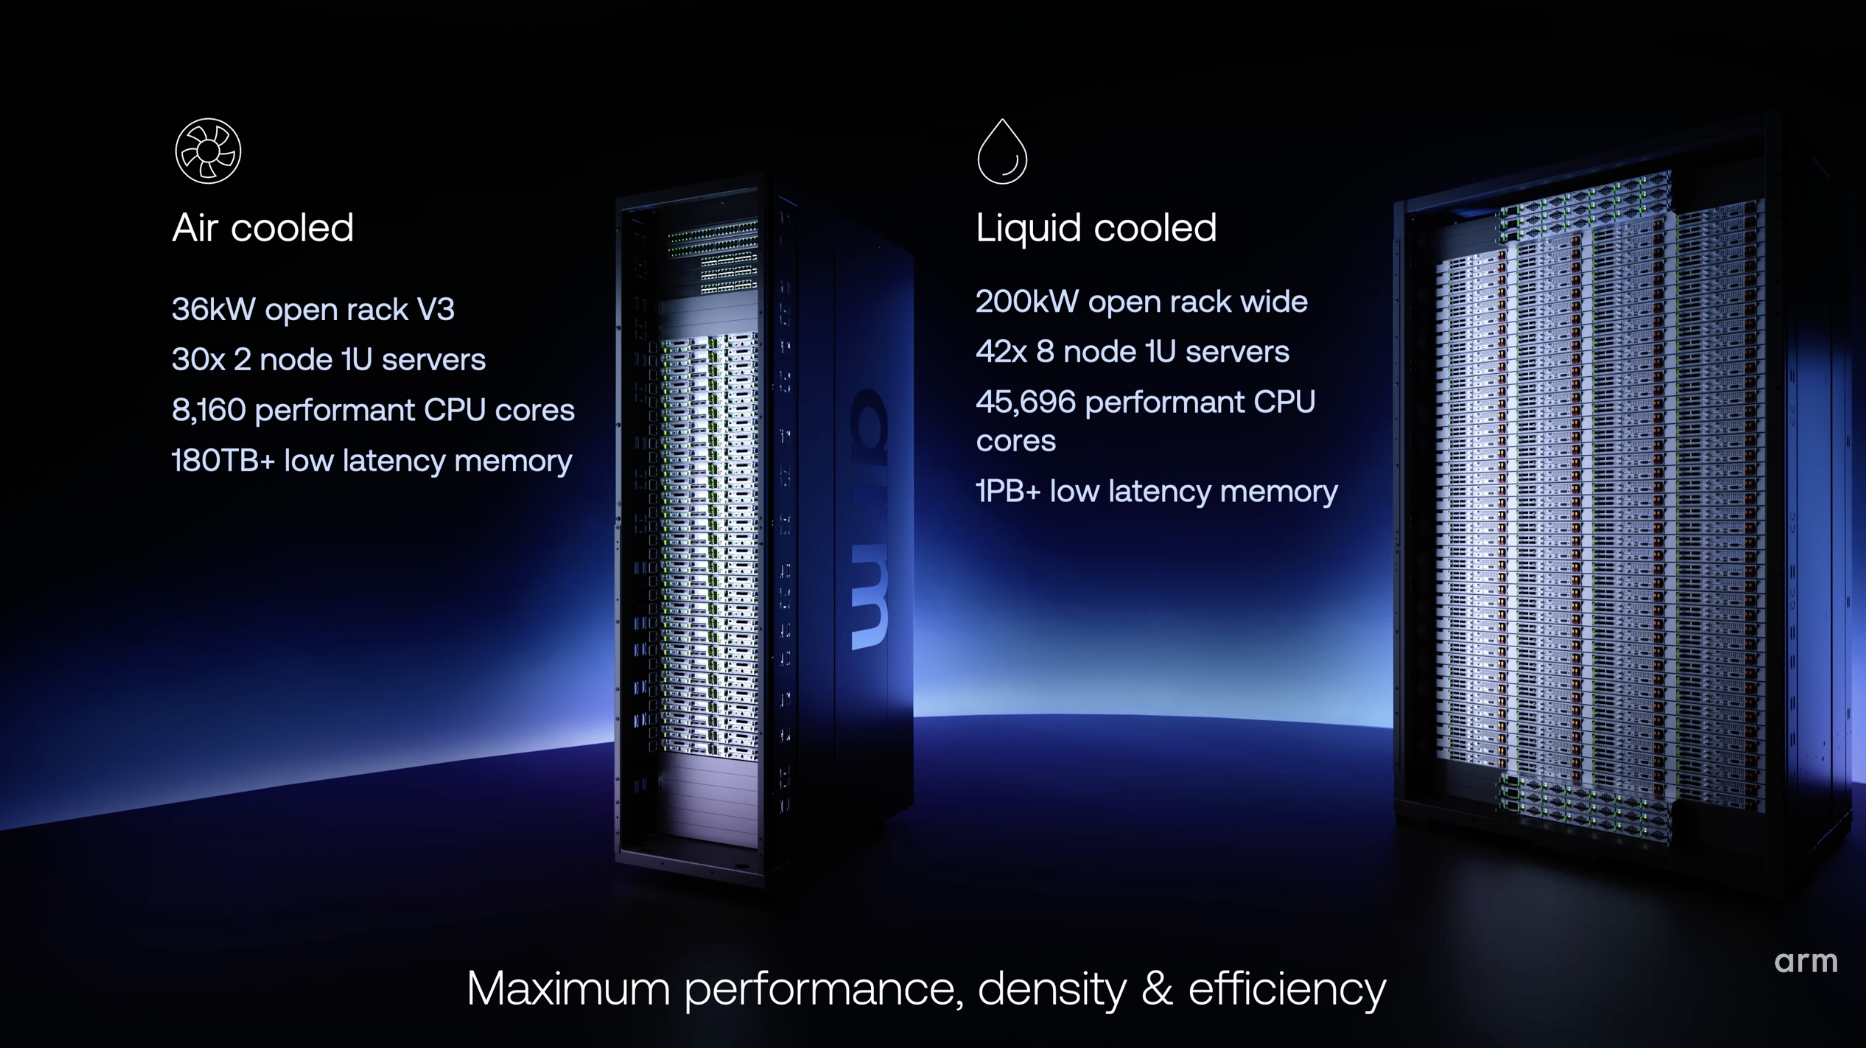
与 Nvidia 相同,Arm 也推出单独的 CPU Rack,分为风冷和液冷 2 种版本。风冷版本的单一个 rack 仅有 30 个 1U compute tray,一个 compute tray 共 2 个 Arm AGI CPU,共整合 60 个 Arm AGI CPU,整体核心数/线程数仅为 8,160/8,160,内存容量仅约 180 TB。液冷版本的单一 rack 则有 42 个 1U compute tray,一个 compute tray 共 8 个 Arm AGI CPU,可以整合 336 个 Arm AGI CPU,整体核心数/线程数可达 45,696/45,696,内存容量高达 1 PB。
图 6. Arm AGI CPU Rack
 来源:Arm
SoftBank 旗下的 Arm 架构 CPU 供应商 Ampere,继 4Q23 推出核心数/线程数为 192/192 的 AmpereOne、AmpereOne M 后,预计在 2026 年进一步推出核心数/线程数高达 256/256 的 AmpereOne MX。
在美系四大 CSP 中,AWS 最早在 2016 年推出第一款自研 CPU Graviton,采用台积电 N16 工艺。2025 年 12 月进一步推出 Graviton5,采用台积电 N3 工艺,核心数/线程数达 192/192。通过使用自研 CPU 搭配自研 AI ASIC Trainium3,AWS 得以降低 AI 运算的成本。
Microsoft 为第二个推出自研 CPU 的 CSP,于 2023 年 11 月同步发布 AI ASIC Maia 100 和 Cobalt 100 CPU,采用台积电 N5 工艺。2025 年 11 月再推下一代的 Cobalt 200,采用台积电 N3 工艺,核心数/线程数为 132/132。
2024 年 4 月,Google 跟进推出首款自研 CPU Axion C4A,采用台积电 N5 工艺。2026 年,Google 进一步推出 Axion C4A 的裸金属版 Axion C4A metal,核心数/线程数为 96/96,以及下一代的 Axion N4A,核心数/线程数为 64/64,旨在打造最高性价比的 CPU。
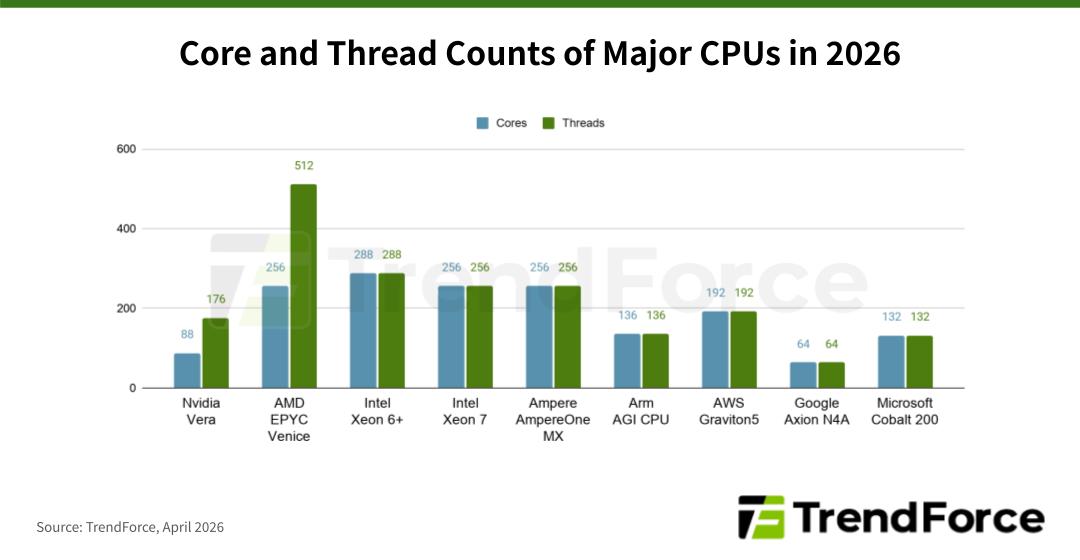
下表汇整 2026 年主要 CPU 的核心数/线程数,可以观察在 2026 年 Intel Xeon 6+ (Clearwater Forest) 将达到最大核心数 288 个,其次为 AMD EPYC Venice、Intel Xeon 7 (Diamond Rapids)、Ampere AmpereOne MX 的 256 个核心。然而,由于采用同步多线程 (Simultaneous Multithreading, SMT) 技术,AMD EPYC Venice 可以在 256 个核心中执行 512 个线程,将达到目前最大线程数。
图 7. 2026 年主要 CPU 核心数/线程数
 来源:TrendForce(Unit:个)
各大 CSP 自研 CPU 的趋势也预计为 IC 后段设计服务商带来额外商机,如目前除了 AWS 维持 in-house 设计,Google、Microsoft 皆委由创意电子 (GUC) 进行 CPU 后段设计服务。
有关 NVIDIA scale-up 生态系统演进及 ASIC 定位的深入分析,请参阅 ASIC 能否超越 GPU?NVIDIA Scale-Up 技术与未来发展。