
KV Cache 容量与带宽双重挑战,解析 HBF、SSD POD 等新技术如何补位?
随着 Test-time Scaling 展开,AI 产业重心正从训练 (Training) 快速转向推理 (Inference)。Nvidia、Google 等 AI 巨头纷纷在 2026 年上半年推出 Inference 专用芯片,Cerebras、SambaNova、Etched 等 AI ASIC 新创公司也密集发表新品与策略合作。伴随这波转变,存储器阶层迎来结构性的变革,各厂商试图运用 HBF、SSD POD、SRAM 等突破传统 HBM 的容量与带宽上限。
本文将分析 AI Training 的存储器需求、AI Inference 的存储器需求及从 Training 到 Inference 的存储器结构变化。
AI Training 的存储器需求
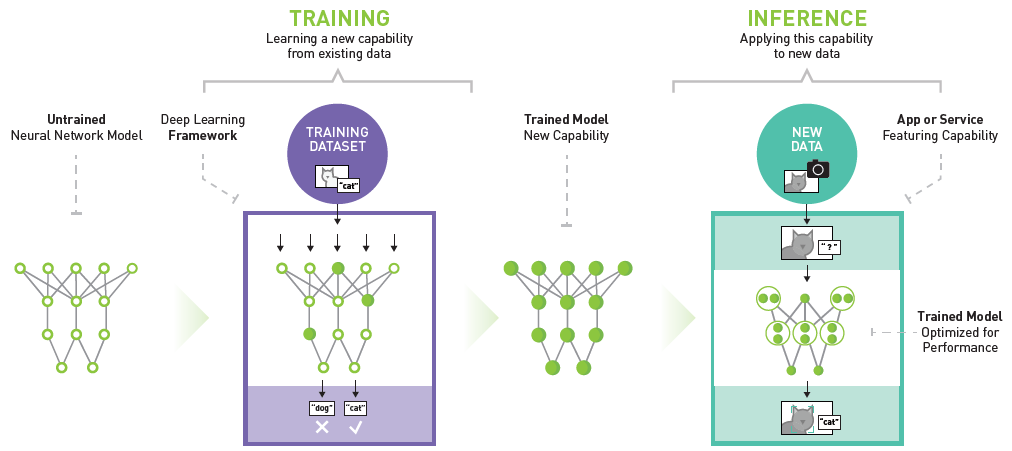
AI Training 意指使用训练数据集 (Training Dataset) 使 AI 模型学习新功能的过程;AI Inference 则意指将训练好的 AI 模型套用到全新的数据,生成相对应回应的过程。由于这两阶段所需要的存储器类型大不相同,也导致近年来存储器的架构愈趋多元。
图 1. AI Training 与 AI Inference 工作流程示意图
来源:NVIDIA
AI Training 方面,以现今普遍的 Transformer 架构为例,训练过程主要包含 3 个阶段:
- Forward Pass:从存储器中读取每一层的权重送进 compute die,进行大量矩阵乘法以计算预测输出,并使用损失函数 (Loss function) 将预测输出与正确答案比对,衡量误差 (Loss)。
- Backward Pass:依照链式法则 (Chain rule) 一层一层从存储器中读取在 Forward Pass 过程中暂存的 activation,反向计算与权重同尺寸的梯度 (gradient)。
- Optimizer Update:读取 gradient 后,更新并写回权重本身,以及 2 份与权重同尺寸的 Optimizer 状态张量 (一阶动量 m、二阶动量 v)。
由于 AI Model 需要不断重复这 3 个阶段,才能以最小化 Loss 的目标不断更新权重,直到收敛。因此,存储器的存取速度成为决定 Training 效率的关键。
图 2. AI Training 流程示意图 (以 Decoder-only Transformer 为例)
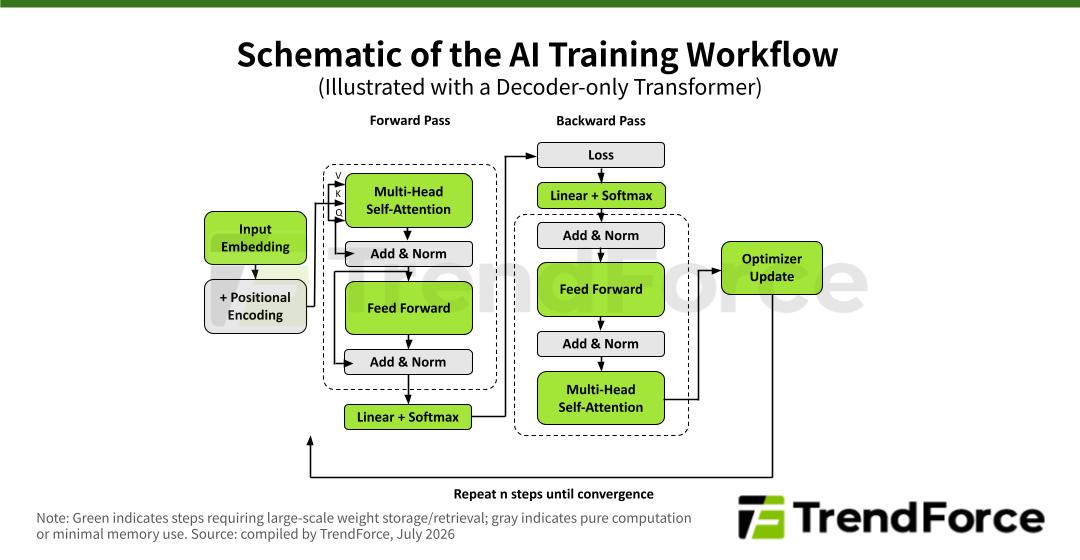
注:绿色 = 需要存放/读取大量权重;灰色 = 纯运算或仅需极少存储器
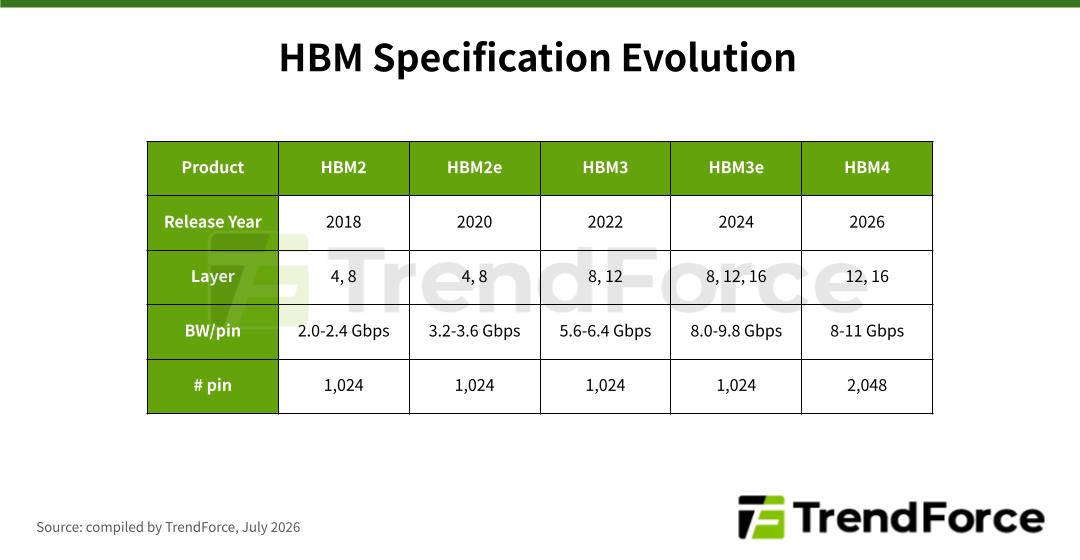
为此,由多层 DRAM 垂直堆叠,并以 TSV 串联而成的 HBM (High Bandwidth Memory) 应运而生。相较于传统 DRAM 以缓慢的 PCIe 连接 (PCIe 6.0 x16 单向带宽达 128 GB/s),HBM 可以与 compute die 并排封装在同一个 interposer 上,缩短了传输距离,且单颗可以提供 >2 TB/s 的带宽 (HBM4 单 pin 单向带宽 >1 GB/s,共 2,048 pin),大幅加速了 AI 产业化的进程。
图 3. HBM 规格演进:HBM2 至 HBM4
因此,在 Training 时代,存储层级便新增了 HBM 这一层,补足 On chip SRAM 与传统 DRAM 之间的存储器需求。
图 4. AI Training 所需的存储层级
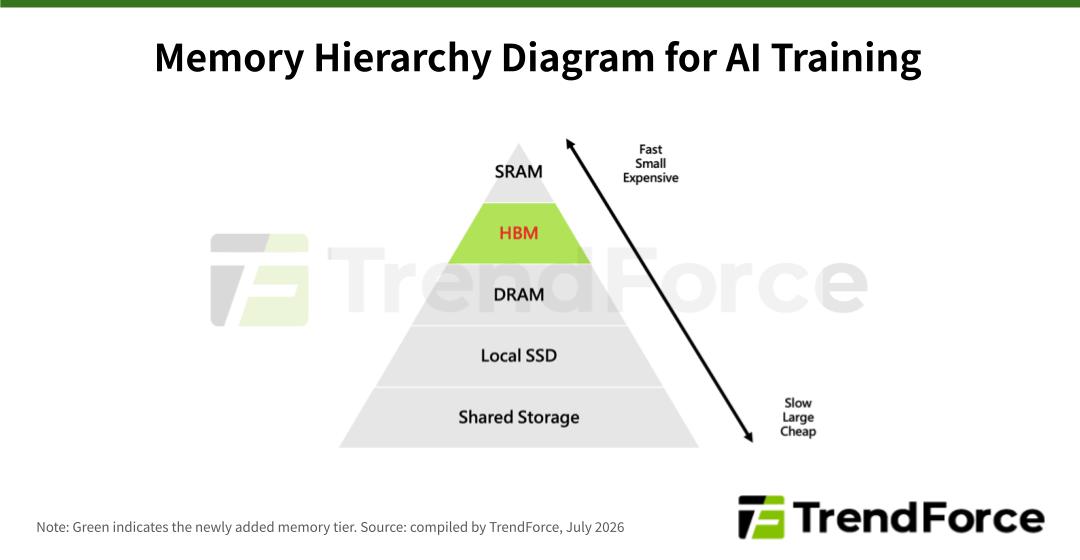
注:绿色 = 新增的存储层级
AI Inference 的存储器需求
AI Inference 主要包含 2 个阶段:
- Prefill:将输入的 prompt 一次性的平行处理,计算出每一层的 Key、Value 矢量存入存储器 (KV Cache) 中,并同时算出第一个生成的 token。
- Decode:从存储器 (KV Cache) 中读取 Key、Value 矢量逐一生成 token,并将新算出的 Key、Value 矢量持续写入其中,直到响应生成完成。
由于 Decode 阶段需要逐 token 反复读写 KV Cache,且 KV Cache 容量会随对话轮数、上下文 (Context Window)、batch size 数字增长而不断成长,单纯仰赖 HBM 已逐渐不足以应付日益增长的 Inference 需求。存储器的容量成为带宽以外的第二个关键瓶颈。
图 5. AI Inference 流程示意图
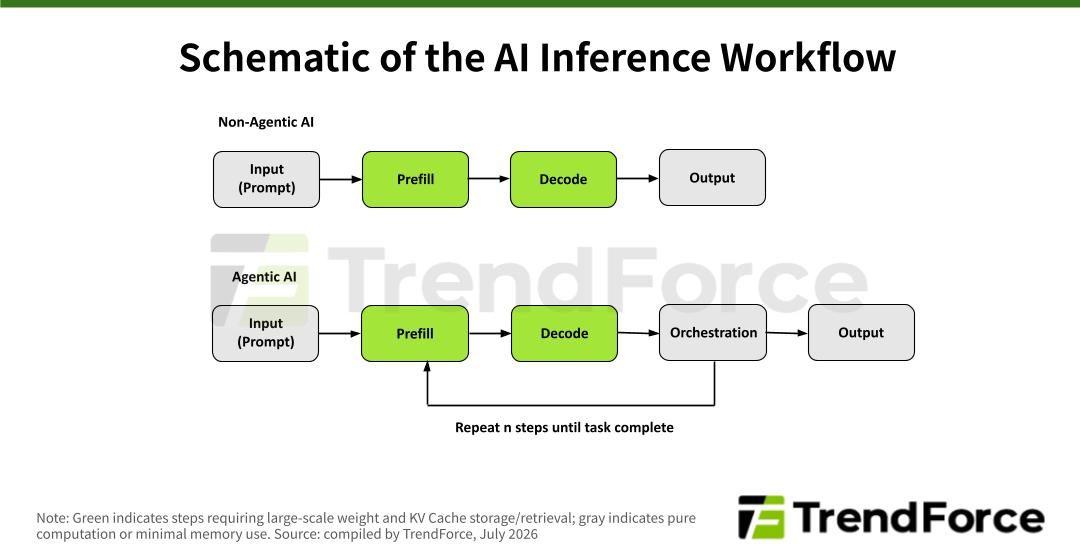
注:绿色 = 需要存放/读取大量权重与 KV Cache;灰色 = 纯运算或仅需极少存储器
与已经相对成熟的 AI Training 存储器架构不同,AI Inference 才刚随着 Test-time Scaling 快速发展,因此各家厂商仍在积极尝试不同的存储器方案,存储层级正处于典范转移的阶段。
为了应对更大的 KV Cache 容量需求,存储器大厂 SanDisk 与 SK hynix 于 2025 年 8 月宣布合作开发 HBF (High Bandwidth Flash),试图将多层 NAND 垂直堆叠,并以 TSV 串联。预期在 1.6 TB/s 的带宽下,单颗 HBF 可以提供约 512 GB 的容量,约为 HBM 的 10 倍 (16-Hi HBM4 容量为 48 GB) 以上,补足 HBM 与传统 DRAM 之间的存储器需求。
在 HBF 量产前,许多厂商也运用 KV Cache Offloading 技术将较不常用的 KV Cache 卸载到较低的存储层级,协助分担大量 KV Cache 的存放需求。因此,Nvidia 于 2026 年提出 SSD POD 的概念,补足 Local SSD 与 Shared Storage 之间的存储器需求。
值得注意的是,除了 HBF、SSD POD,有些 Inference ASIC 初创公司推出高速的 SRAM,突破 HBM 的速率极限;例如 Groq(NVIDIA 于 2025 年 12 月取得其 Inference 技术授权和核心团队)、Cerebras 即通过大片的 On chip SRAM 大幅提升 decode 速率。
若想深入了解 AI Inference 如何重塑供应链的存储器需求,请参阅 AI 推理如何创造新的存储器需求?
图 6. AI Inference 所需的存储层级
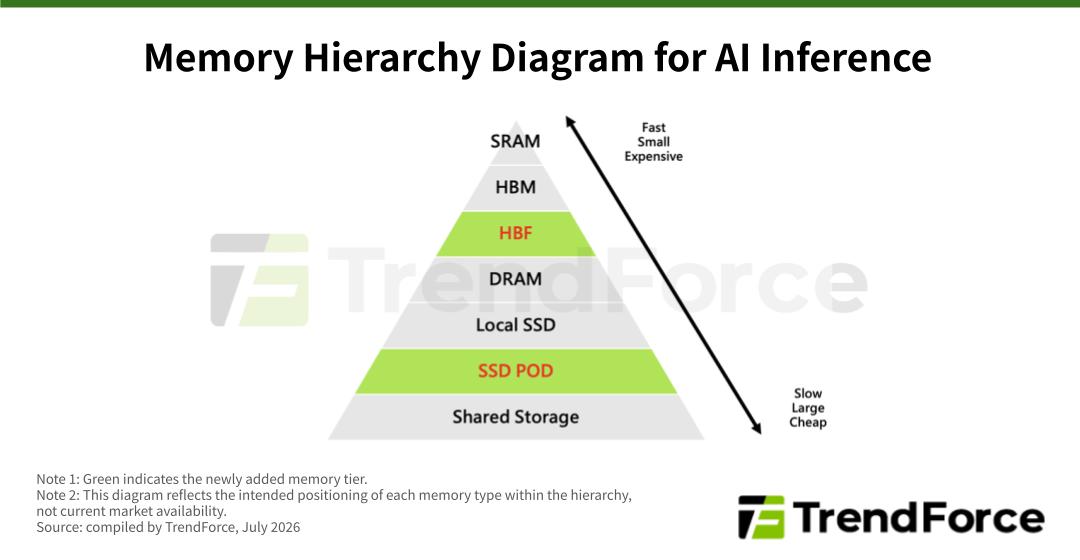
注:绿色 = 新增的存储层级
从 Training 到 Inference 的存储结构变化
2026 年上半年,由于 Inference 需求持续爆发,Nvidia 宣布于年底将上市的 Rubin 系列中加入 Groq LPX 芯片,并同步推出 CMX (Context Memory Storage Platform) 与 Vera CPU Rack。
Google 也发表针对 Inference 设计的 TPU v8i,相较针对 Training 设计的 TPU v8t 多出 72 GB 的 HBM3e 与 384 MB 的 SRAM。
除了 2 大巨头之外,许多设计 Inference 专用芯片的 AI ASIC 初创公司在 2026 年上半年积极布局,如 Sambanova 于 2026 年 2 月推出第 5 代芯片 SN50;Cerebras 于 2026 年 4 月申请挂牌上市,并宣布与 OpenAI、AWS 合作;Etched 于 2026 年 6 月宣布其 Sohu 芯片已在台积电成功流片 (tape out)。
若想进一步了解各 Inference 芯片在存储器架构上的差异,请参阅 推理经济时代来临:AI 芯片的规则正被重写。
图 7. Training 与 Inference 流程所需的关键存储器
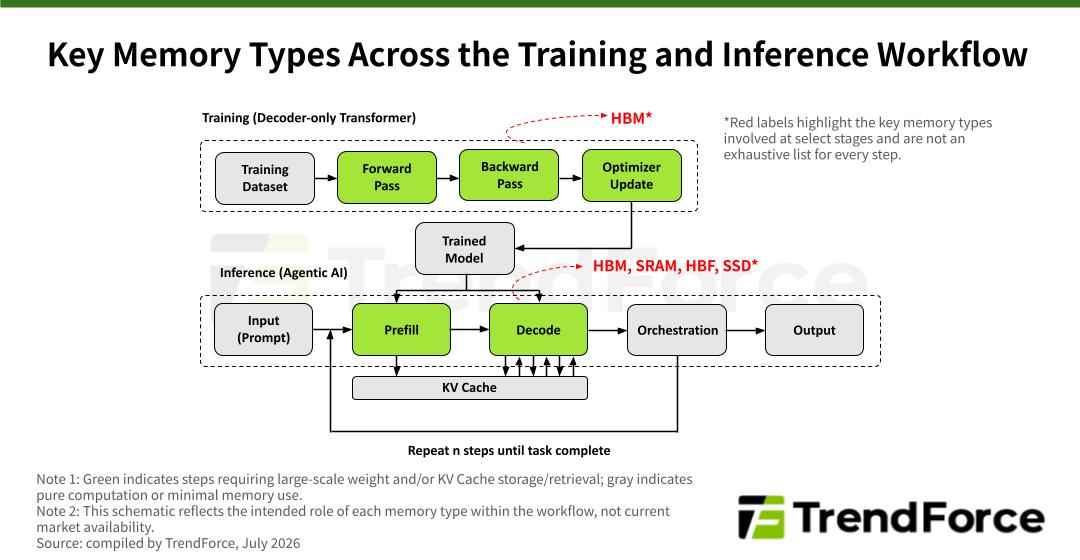
图 8. 从 Training 到 Inference 的存储层级变化
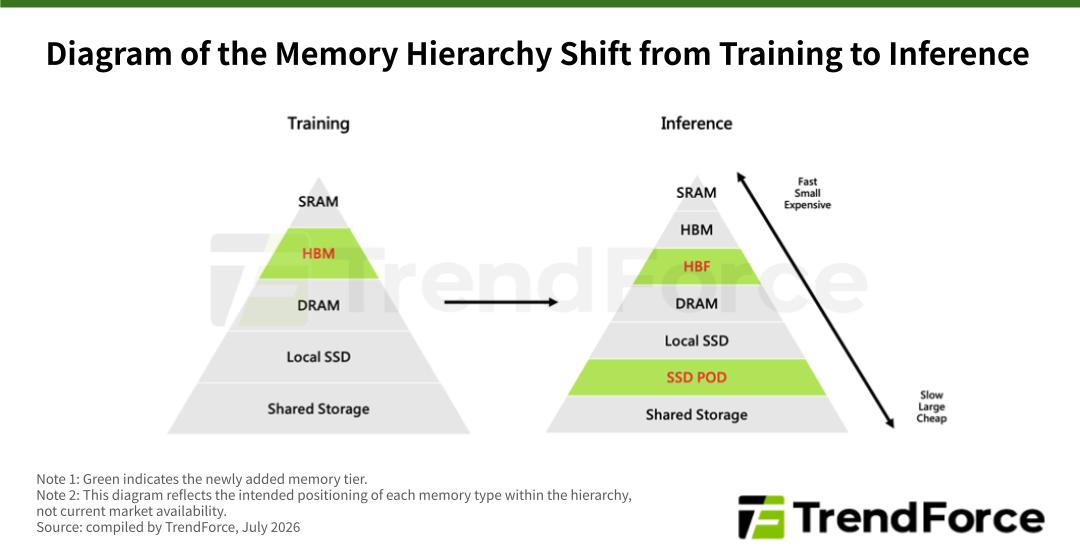
注:绿色 = 新增的存储层级