
Computex 2026 聚焦 Agentic AI,推理效率成为胜出关键。回顾 Groq、Taalas、Cerebras 推理芯片技术进展。
Agentic AI 驱动新一波算力需求,AI 产业的算力竞争重心,正在从训练移向推理(Inference)。推理效率也成为 Computex 2026 展会最核心的议题。
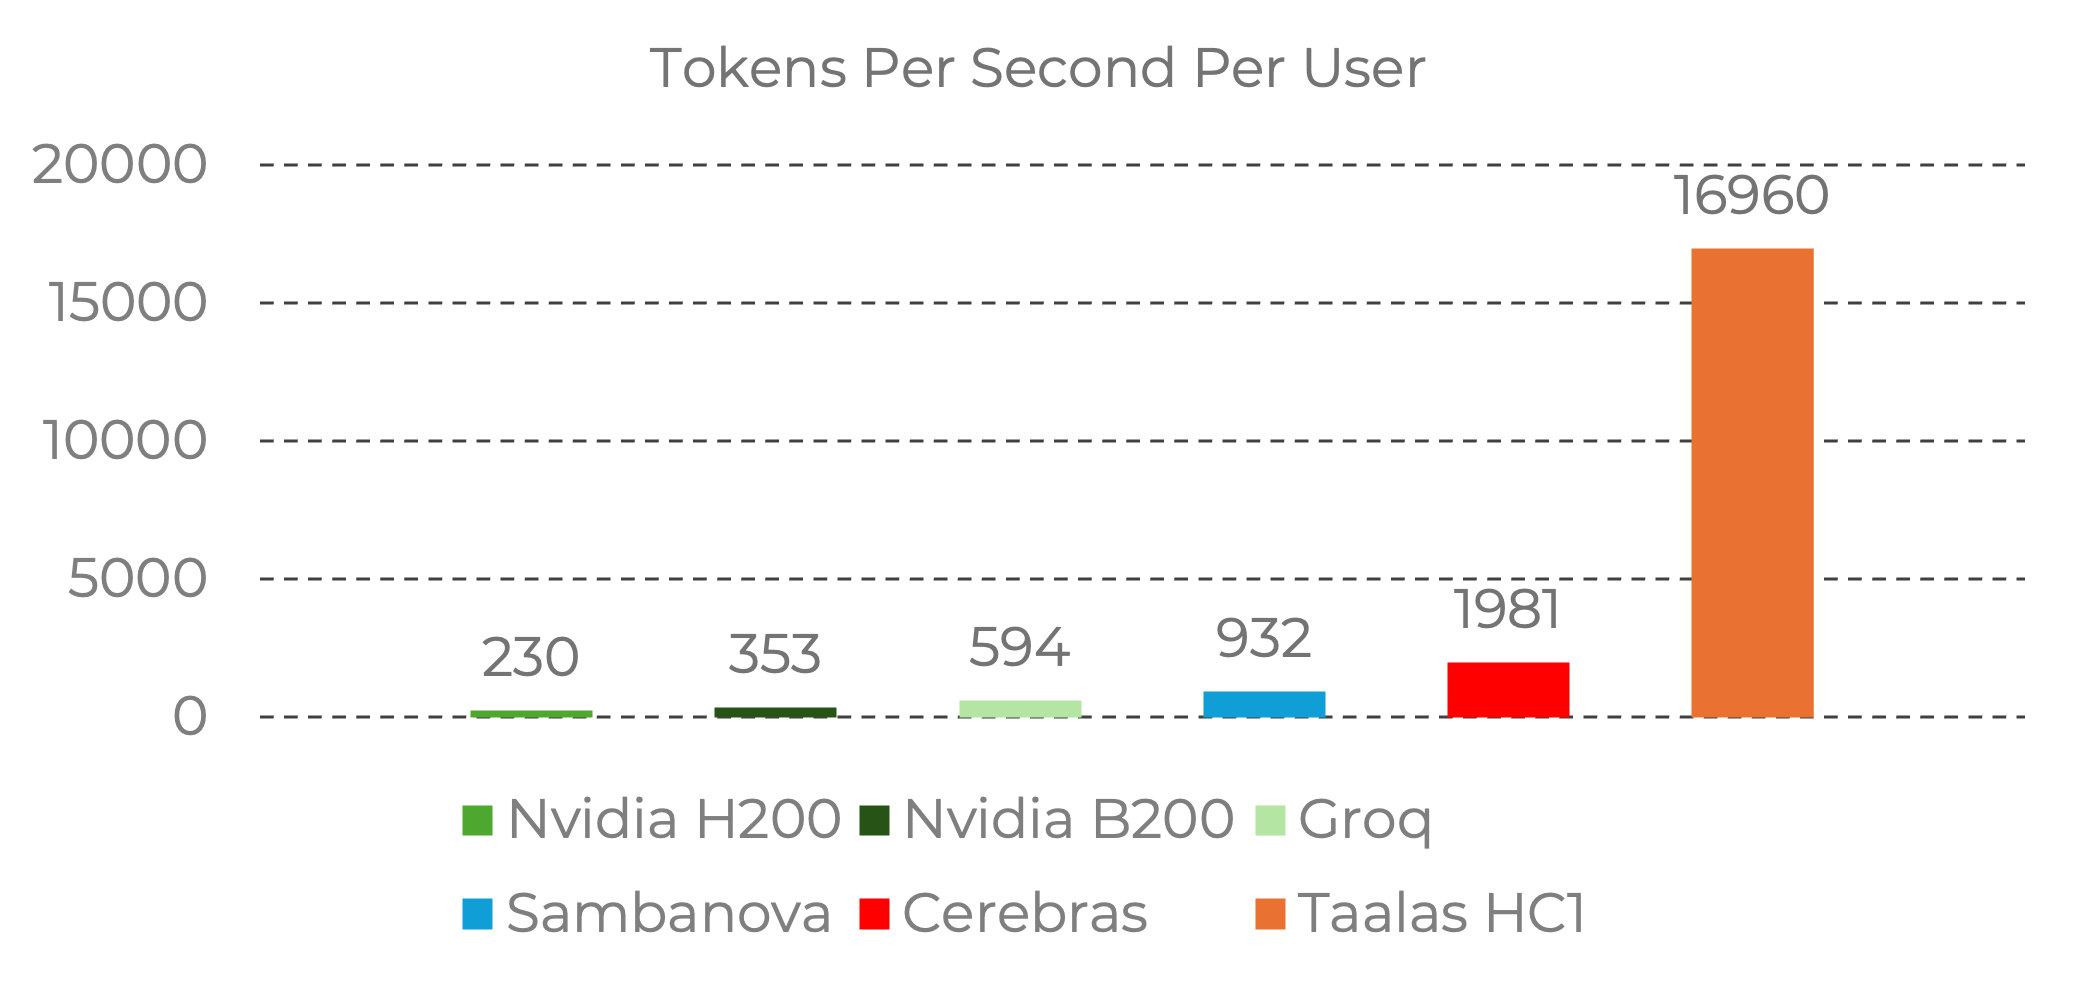
2025 年 12 月 24 日,Nvidia 以 200 亿美元取得 Groq 的 Inference 技术授权与核心团队。两个月后,2026 年 2 月 20 日,加拿大 AI 芯片新创 Taalas 发表推理芯片 HC1,在 Llama 3.1 8B 模型实现 16,960 tokens/s/user 的极高速率,每百万 tokens 推理成本约为 Nvidia B200 throughput optimized 模式的五分之一。2026 年 5 月 14 日,Cerebras 正式挂牌上市,市场再度将目光看向 AI Inference 芯片这个赛道。
从 Nvidia 的百亿押注、新创的密集出场,到资本市场开始替这类公司定价,反映着在 AI 推理时代,产业竞争已从“更大”转向“更有效率”的模型。本文将探讨:
- AI 产业从训练逐步迈向推理的发展趋势
- 通用 GPU 的架构瓶颈
- 硬式编码推理芯片优势与挑战
- 高效率 Inference 芯片新创公司比较
产业重心位移:训练导向转为推理导向
2022 年生成式 AI 崛起初期,产业竞争聚焦于模型训练,谁能训练出更强模型,谁就握有话语权,于是厂商以巨额支出堆栈参数与芯片资源,换取模型规模与能力的跃升。
然而,随着 AI 服务进入常态化部署,成本压力的结构已改变。推理是高频、长期与营收直接连动的成本中心,单位推理成本与能效表现将直接影响毛利率与规模扩张能力。 每一次 API 呼叫、每一个生成 token,都代表算力消耗与毛利压力。若 token 生成成本无法随规模下降,商业模式的存续将受到挑战。
在此背景下,软硬件发展焦点遂转向吞吐量、能效比与存储器架构优化,强调数据搬移效率与低延迟设计,而非单纯追求峰值算力。
通用 GPU 架构的技术瓶颈
过往通用型的 GPU 依赖 HBM 与外部 DRAM 储存模型权重,计算核心与存储器分离,数据需频繁在芯片与封装间搬移,当推理流量呈现长期、连续成长,通用 GPU 架构的技术瓶颈逐渐浮现。
对以矩阵乘法为主的 Transformer 推理而言,存储器带宽与存取延迟是主要瓶颈。HBM 虽然提供高带宽,但封装复杂、良率与成本压力并存,功耗亦随带宽提升而攀升。若推理任务多为低批次(Low Batch)、高实时性请求,GPU 难以大规模并行优势摊提成本,导致性能利用率下降,能效比与单位 Token 成本成为真正的限制条件。
另一方面,由于模型规模不再是衡量竞争力的唯一指标,市场开始尝试通过各式技术压缩模型并维持其推理能力,例如 1.58-bit 量化技术与权重剪枝,使模型可在极低存储器占用下维持推理准确度;MoE(混合专家)架构则通过“部分启动”机制,在每次推理仅唤醒少数专家子网络,大幅降低实际运算量。
精简模型的崛起,为硬件设计开创新的发展方向:当模型权重与结构趋于稳定,不再需要昂贵的动态存储器支撑灵活性,将算法直接编码刻入芯片的技术便具备商业潜力。
硬式编码推理芯片:功耗、散热与资本效率具优势
硬式编码推理芯片因应效率瓶颈而生,Taalas 等厂商通过将模型权重固化于 Mask ROM,并以片上 SRAM 处理动态数据,大幅降低外部存储器搬运功耗,显著提升每瓦与每美元 Token 产出。最大效益为低延迟、低功耗与高吞吐,并可简化散热与封装设计。
然而,市场对其最大疑虑在硬件缺乏弹性,难以应对快速迭代的模型更新。其次,弹性不足是其结构性风险,相较可程序化架构,专用芯片几乎没有调整空间,应用场景必须高度稳定且规模足够,才能摊提高额 NRE(一次性工程费用,Non-Recurring Engineering)成本。再者,生态系亦是关键门槛,当前云端市场仍依赖通用平台,客户可能更偏好可随模型升级的弹性解决方案。为降低风险,厂商通过自动化模型转芯片流程、预制晶圆与混合可编程架构,并结合量化与 LoRA 微调设计,在“硬化”与“弹性”间取得折衷,使专用化得以商业落地。
未来硬式编码技术预期将锁定亚毫秒级反应与封闭场景,其模型结构稳定、隐私要求高与部署规模明确,硬式编码芯片可在标准气冷机柜中运行,降低能耗与资本支出,对云端服务商与垂直整合商尤具吸引力,对传统依赖软件编译调度的 ASIC 厂商,则将遭遇性能挑战。
TrendForce 预期通用 GPU 仍主导训练与多模型环境,但在成熟、可预测场景中,其利润空间将受到压缩,产业格局因此从通用算力垄断,走向通用与专用并行的双轨结构。
Taalas HC1:硬式编码推理的概念验证
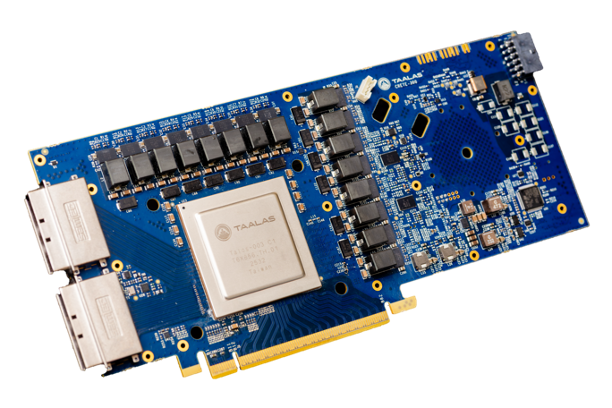
2026 年 2 月 20 日,加拿大 AI 芯片新创公司 Taalas 发布 Taalas HC1,将 Meta 的开源 AI 模型 Llama 3.1 8B 模型直接刻印在芯片中,可以实现 16,960 tokens/s/user 的极高速率。
不仅如此,Taalas HC1 使用台积电 N6 制程,且不使用 HBM 存储器、CoWoS 封装,单一芯片功耗仅约 250 W,可采用气冷散热。因此,相较于 Nvidia B200(throughput optimized)运行 Llama 3.1 8B 的每百万 tokens 成本为 3.79 cents,使用 Taalas HC1 的每百万 tokens 成本仅为 0.75 cents,约为其五分之一。
图 1. Taalas HC1 芯片:直接将 Llama 3.1 8B 模型 hard-wire 在芯片
来源:Taalas
图 2. Taalas HC1 于 Llama 3.1 8B 模型之单用户推理速率(tokens/s/user)
来源:Taalas
Taalas 的高效率归功于采用存储器内运算(Computing-in-Memory, CIM)的概念,也就是将运算功能整合至存储器,达到“存算一体”,以消除数据在运算单元、存储器之间频繁传输的需求,去除存储器墙的限制,即能降低运算时的多余延迟及功耗。
存储器内运算是什么?
自 1945 年数学家 John von Neumann 发布冯.诺依曼架构(von Neumann architecture)以来,芯片设计遵循运算器(Central Arithmetical, CA)、储存单元(Memory, M)等组件分离的设计,以保留较大的灵活性。
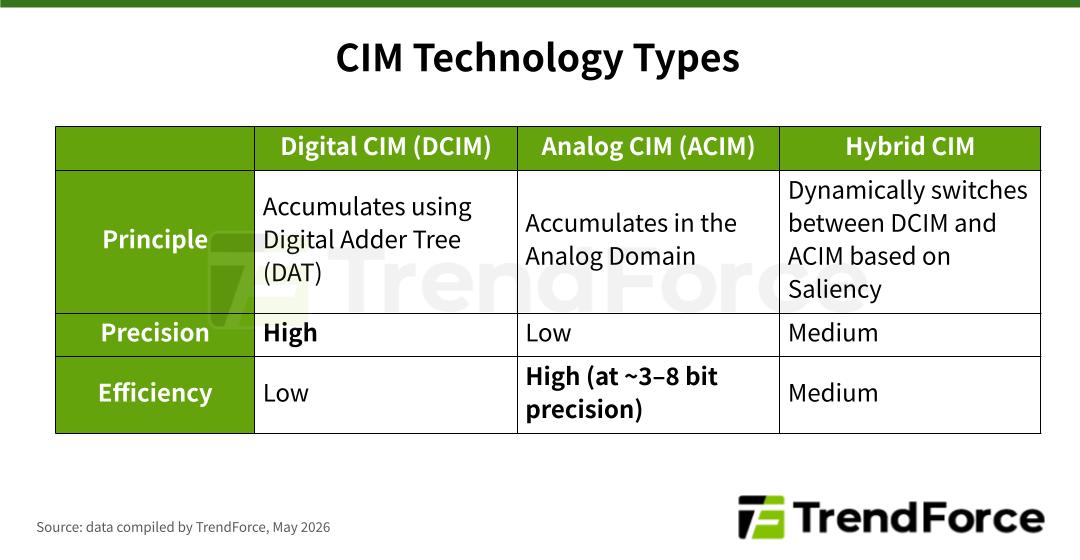
随着存储器带宽与算力成长逐渐不匹配,数据在运算单元、存储器之间的传输成为瓶颈,存储器内运算(Computing-in-Memory, CIM)便应运而生,目前已发展出数位 CIM(Digital CIM, DCIM)、类比 CIM(Analog CIM, ACIM)、混合 CIM(Hybrid CIM)等。不过,可以运行 CIM 的程序语言、软件底层架构、应用程序皆尚未开发完全,技术仍在初期发展阶段。
图 3. CIM 三大技术类型:涵盖 Digital CIM(DCIM)、Analog CIM(ACIM)与 Hybrid CIM 三种类型,并就其运作原理、精度与效率进行比较分析。
 相较于一般 CIM 技术,Taalas 采取更激进的硬式编码(hard-coded)做法。以“The model is The Computer”为开发理念,创造完全由硬件定义的 AI 硬件模型(hardcore model),将 AI 模型的权重直接刻印在芯片的 Mask ROM 中,在享有 CIM 技术的低延迟、低功耗的优点同时,也避开了 CIM 软件生态系尚未成熟的瓶颈。
除了运算效率极高,由于使用高密度的 ROM 储存模型权重,Taalas 仅需修改 2 层光罩就能产出另一个 AI 模型的专用芯片,将一个 AI 模型转化为实体芯片仅需 2 个月。同时,Taalas 也保留一部分 SRAM 用于储存 KV cache 和 LoRA 微调权重,弥补缺乏灵活性的缺点。
尽管实现方式不同,Taalas 的完全硬件定义技术与 Groq 的完全软件定义技术目标一致,即尽可能达到静态调度(static scheduling)、完全确定性(fully deterministic)的运算,借由牺牲动态灵活性,换取最高效率。
多元并进的推理芯片新纪元
不仅 Taalas,专研高效率 Inference 应用的 AI 芯片新创公司陆续起步,象是 Tenstorrent、Groq、Cerebras、SambaNova、MatX、Untether AI、Hepzibah AI、Etched、d-matrix、Positron AI、Axelera AI、FuriosaAI 等。各厂芯片规格汇整如下图:
图 4. 高性能 AI Inference 芯片的技术架构与规格比较,技术类型涵盖 CIM、SRAM-First、RISC-V 及晶圆级整合等
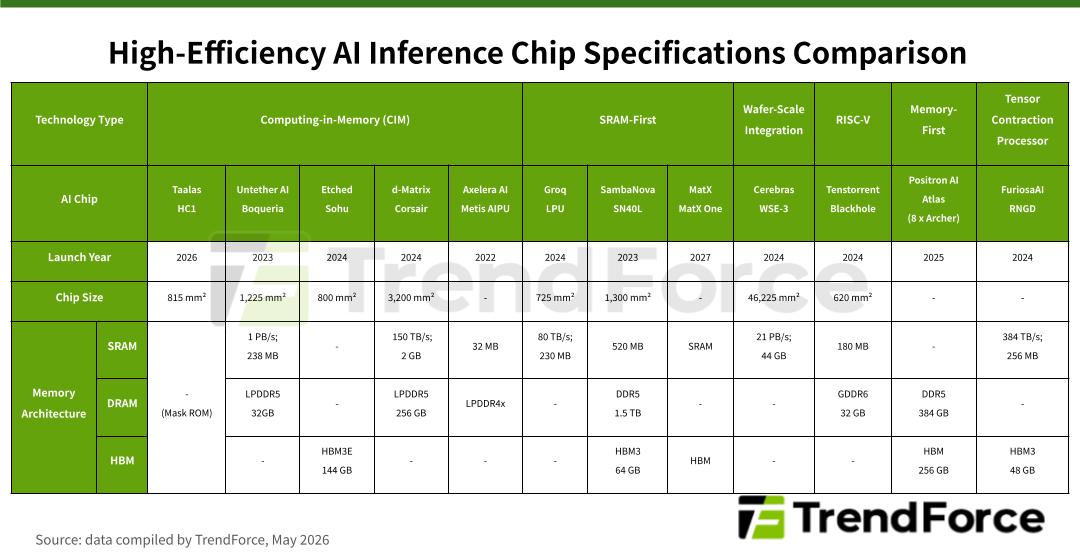 需注意的是,TrendForce 以 CIM 泛指广义的存算一体架构,但各家实现方式不同。Taalas HC1 将模型权重直接固化于 Mask ROM(完全硬件定义);Etched Sohu 与 Taalas 同样采 Hard-wired 架构,但适用所有 Transformer 模型,灵活性较高;d-Matrix Corsair 以数位存储器内运算(Digital Computing-in-Memory, DIMC)为核心,将 AI 模型底层架构刻印在芯片中,适用所有 AI 模型,灵活性比 Etched 更大;Untether AI Boqueria 采 at-memory compute,将 RISC-V 处理器与处理单元直接整合进 SRAM memory bank 内部;Axelera AI Metis AIPU 同样采数位存储器内运算(Digital In-Memory Computing, D-IMC),并以 RISC-V 控制信息流。
图 5. d-Matrix Corsair 芯片架构
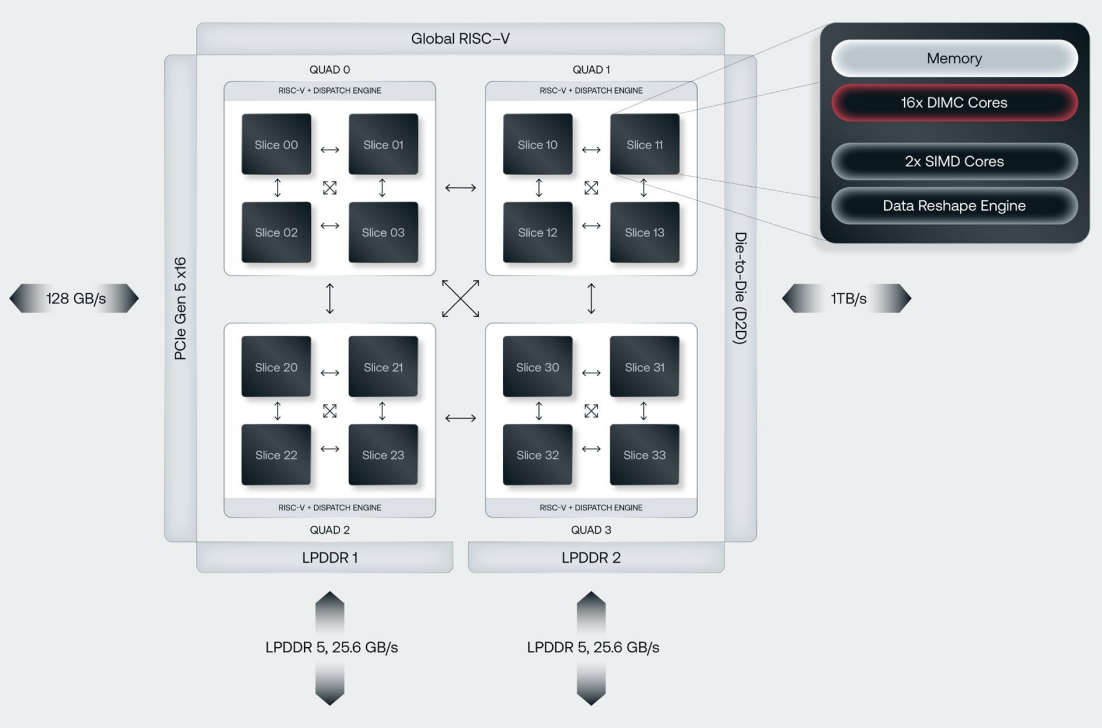
来源:d-Matrix
图 6. Untether AI Boqueria 芯片架构
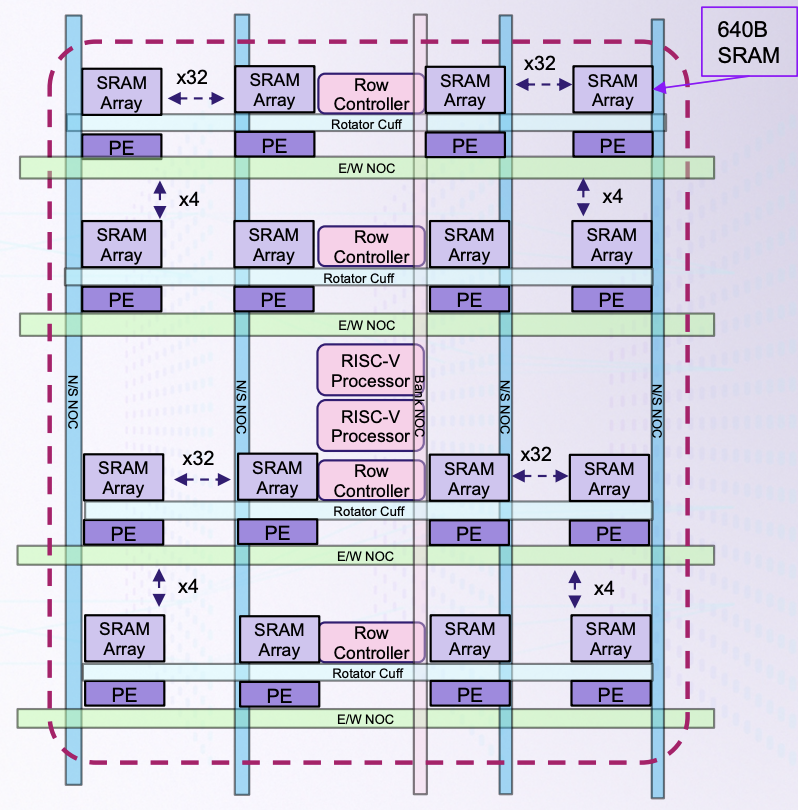
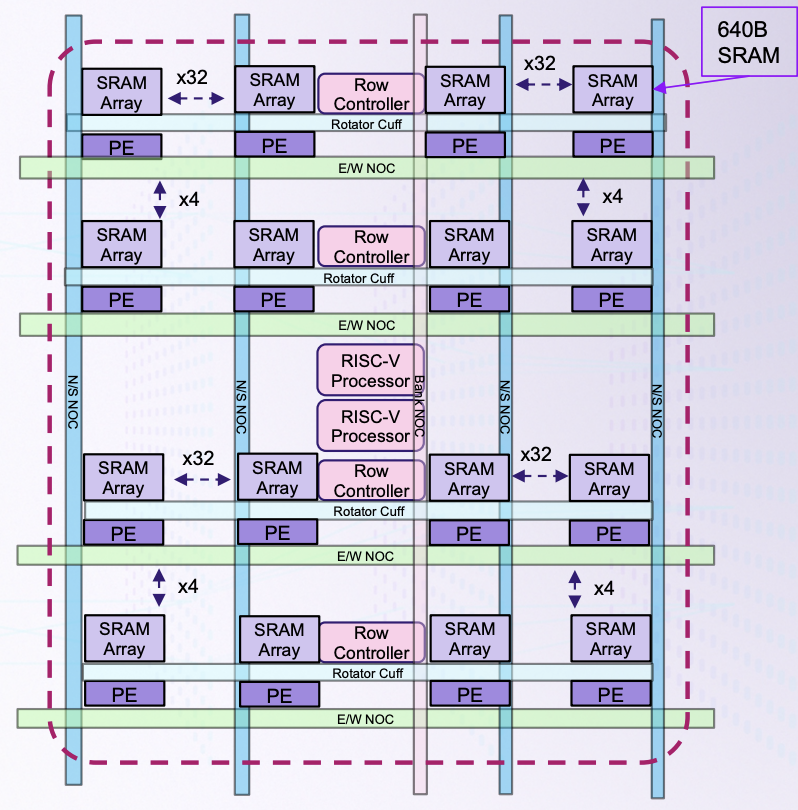
来源:Untether AI
另一方面,近期热度最高的 Cerebras 于 2026 年 5 月 14 日在那斯达克挂牌上市。其核心技术为晶圆级整合(Wafer-Scale Integration, WSI),通过将整片 12 英寸晶圆做成单一芯片(WSE-3),实现 44GB 片上 SRAM 与 21 PB/s 带宽,并已与 OpenAI 签订逾 200 亿美元、规模 750MW 的三年算力合作协议。
图 7. Cerebras WSE-3 芯片架构
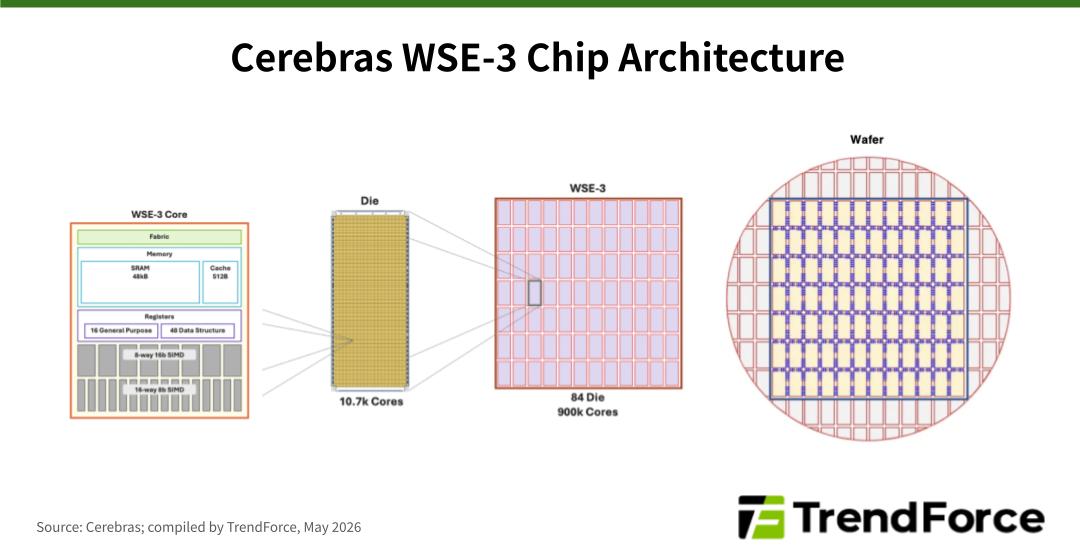
来源:Cerebras, TrendForce (2026/05)
目前,市场处于多线并进的早期探索期,各家新创同步尝试不同的技术路线,象是存储器内运算技术、以 SRAM 为主的架构、晶圆级整合、张量收缩等多元设计思维。预计未来 Inference 芯片架构将逐步融合各项技术,以符合 AI Inference 高速率、低功耗的运算需求